阅读时间 24.1.12
1. 引言
本文主要使用CLIP的视觉编码器来完成Vision-and-Language (V&L) tasks。
2.背景
Vision-and-Language (V&L) tasks包括视觉问答、图片注释、Vision-and-Language navigation、图文检索。
3.实验数据
在三个任务上体现出CLIP-ViL的优势。
收获
unfreezing the visual backbone in V&L model:冻结视觉编码器或者语言编码器,使得在微调的时候里面的权重不会改变。用以保证模型所学的视觉或文本特征不变的情况下,微调另一编码器权重,可以加速迅训练或者过拟合(优化参数量减少)
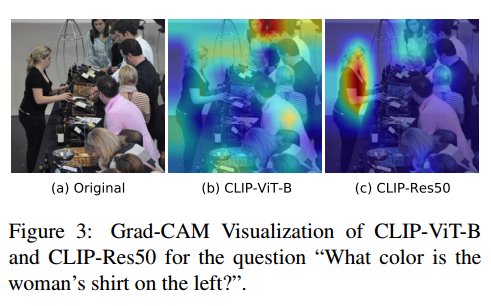
Gradient-Based Localization(Grad-CAM)是一种用于可视化深度学习模型中的显著区域或注意力热图的方法。可以用它来观察不同模型之间的注意力区别。效果如下: